Individua i colli di bottiglia prima che gli utenti se ne accorgano: monitoraggio IT proattivo in pratica
Individua i colli di bottiglia prima che gli utenti se ne accorgano: monitoraggio IT proattivo in pratica
Quando un sito web rallenta o un sistema smette improvvisamente di funzionare, gli utenti se ne accorgono subito. Ma spesso i problemi si sono accumulati per giorni o settimane prima di diventare visibili. Il monitoraggio IT proattivo serve proprio a questo: individuare e risolvere i colli di bottiglia prima che si trasformino in veri e propri disservizi. Per riuscirci servono gli strumenti giusti, una strategia chiara e una cultura aziendale che consideri il monitoraggio parte integrante della gestione quotidiana, non solo un intervento d’emergenza.
Dalla reattività alla proattività
Tradizionalmente, molti reparti IT hanno operato in modo reattivo: qualcosa si rompe, e si corre a ripararlo. Ma con l’aumento della complessità dei sistemi e delle aspettative degli utenti in termini di disponibilità e prestazioni, questo approccio non basta più. Essere proattivi significa raccogliere costantemente dati sullo stato dei sistemi e reagire ai primi segnali di anomalia.
Un aumento dei tempi di risposta, un utilizzo anomalo della CPU o un database che cresce oltre la capacità prevista sono tutti campanelli d’allarme. Riconoscere questi segnali in anticipo permette di pianificare interventi di manutenzione prima che gli utenti subiscano rallentamenti o interruzioni.
Cosa monitorare – e come
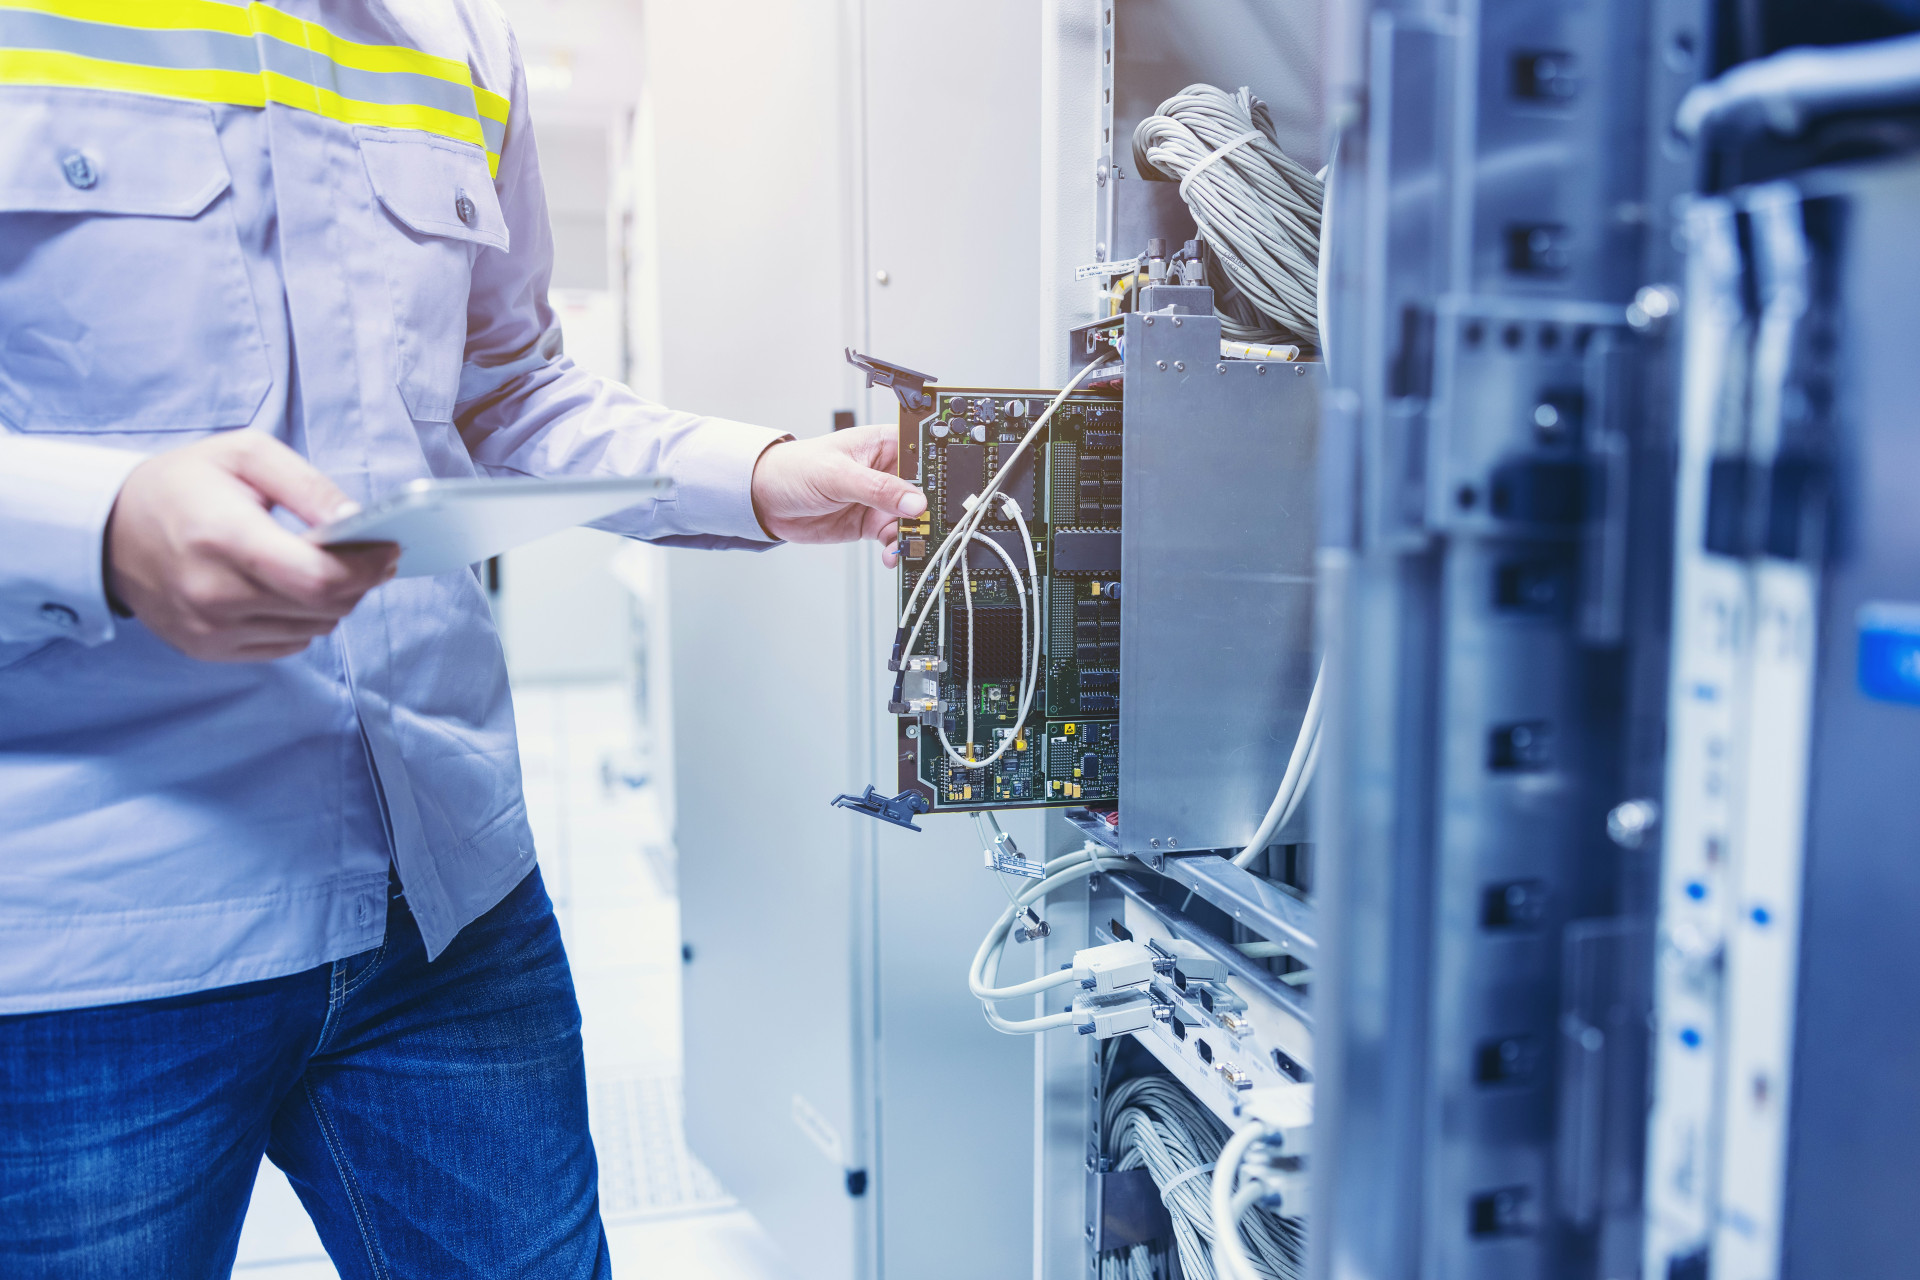
Il monitoraggio proattivo non riguarda solo i server. È necessario comprendere l’intera catena, dall’esperienza dell’utente fino al backend. Per questo, la sorveglianza deve coprire diversi livelli:
- Infrastruttura – server, rete, storage e risorse cloud. L’obiettivo è garantire stabilità e capacità adeguata.
- Applicazioni – tempi di risposta, errori e dipendenze tra sistemi. Anche piccole modifiche al codice o alle integrazioni possono generare colli di bottiglia.
- Esperienza utente – come percepisce il servizio l’utente finale? Strumenti di monitoraggio sintetico possono simulare il comportamento degli utenti e individuare problemi prima che si manifestino realmente.
- Sicurezza – traffico anomalo, tentativi di accesso sospetti o modifiche non autorizzate alle configurazioni possono segnalare violazioni o vulnerabilità.
Combinando questi livelli si ottiene una visione completa, che consente di intervenire in modo rapido e mirato.
Automazione e allarmi intelligenti
Una delle sfide principali del monitoraggio è la quantità di dati generati. Se ogni minima variazione genera un allarme, si rischia di essere sommersi dal rumore. È quindi fondamentale adottare sistemi di allerta intelligenti e processi automatizzati.
Le piattaforme moderne di monitoraggio, spesso basate su intelligenza artificiale, imparano a riconoscere ciò che è “normale” e segnalano solo le deviazioni significative. Allo stesso tempo, script automatizzati possono eseguire azioni standard – come riavviare un servizio o liberare memoria – senza l’intervento umano.
Questo libera tempo prezioso per concentrarsi sui problemi complessi, dove l’esperienza e il giudizio umano restano insostituibili.
Dai dati all’insight
Il monitoraggio produce enormi quantità di dati, ma i dati da soli non bastano: servono analisi e interpretazione. Collegare il monitoraggio a strumenti di reportistica e analisi consente di individuare tendenze e pattern nel tempo.
Visualizzare l’andamento dei carichi, dei tempi di risposta e degli errori aiuta a scoprire correlazioni che altrimenti resterebbero nascoste. Magari si scopre che un’applicazione rallenta sempre in determinate fasce orarie o che un’integrazione fallisce dopo ogni aggiornamento. Queste informazioni permettono di pianificare miglioramenti e ottimizzare le risorse.
Læs også:
Cultura e collaborazione
La tecnologia, da sola, non basta. Il monitoraggio proattivo richiede una cultura condivisa, in cui tutti – sviluppatori, sistemisti e responsabili di business – vedano il monitoraggio come una responsabilità comune. È importante definire insieme cosa è critico e come misurare il successo.
Quando il monitoraggio diventa parte integrante del ciclo di sviluppo – ad esempio attraverso l’“observability” nei processi DevOps – i problemi possono essere individuati già in fase di test. Questo riduce il rischio di interruzioni e migliora la qualità complessiva dei servizi digitali.
I vantaggi di essere un passo avanti
I benefici del monitoraggio proattivo sono evidenti:
- Meno downtime – i problemi vengono individuati e risolti prima che impattino gli utenti.
- Esperienza utente migliore – sistemi più veloci e affidabili.
- Uso più efficiente delle risorse – manutenzione pianificata invece di interventi d’urgenza.
- Maggiore sicurezza – le anomalie vengono rilevate tempestivamente, consentendo una risposta rapida.
In sintesi, il monitoraggio proattivo rende la gestione IT più stabile, prevedibile e orientata al valore.
Un investimento che si ripaga
Implementare un sistema di monitoraggio proattivo richiede investimenti in strumenti e competenze, ma i benefici – meno interruzioni, utenti più soddisfatti e una gestione più efficiente – superano di gran lunga i costi iniziali.
In un contesto come quello italiano, dove la digitalizzazione è ormai un pilastro per imprese e pubbliche amministrazioni, non si tratta più di chiedersi se si possa permettere di monitorare, ma se ci si possa permettere di non farlo.
Læs også: